テレメトリを「契約」として扱う — OpenTelemetry Weaverで試すTelemetry Contract

テレメトリにも互換性の問題がある

何気ない変更が思わぬトラブルに

例えば、あるサービスで request.duration というメトリクスを出していたとします。

開発者が実装を整理する中で、他のメトリクスとの命名を揃えるため、この名前を request.latency に変更しました。
コードの変更自体は小さなものです。アプリケーションも正常に動いていますし、新しい名前でメトリクスも送られています。

ところが、そのメトリクスを使って作られていたチーム内のダッシュボードは値を表示できなくなりました。
同じメトリクス名を参照していたアラートも、期待どおりに動かなくなりました。

問題は利用側で起きる

変更した実装だけを見れば、これはテレメトリの名前を変えただけに見えます。 しかし、そのテレメトリを利用している側から見ると、依存していたものが突然変わったことになります。

名前だけではありません。属性の名前や型、メトリクスの単位、計測方法などを変更した場合も、同じようなことが起こり得ます。

アプリケーションが動いていて、テレメトリも送られているから問題ない、とは言えません。
利用者が依存しているテレメトリを互換性への配慮なく変更すれば、利用者にとってはbreaking changeになります。

テレメトリにも互換性を考える

APIであれば、利用者が依存しているインターフェースを不用意に変更しないのは当然です。
テレメトリも誰かが継続して利用しているのであれば、同じように互換性を考えるべきです。

ただ、互換性を守ると言っても、何を守るのかが曖昧なままでは判断できません。
メトリクス名なのか、属性なのか、型や単位なのか。まずは、提供する側と利用する側の間で「何を提供し、何を維持するのか」を明らかにする必要があります。

「約束」をTelemetry Contractとして考える

この「何を提供し、何を維持するのか」という約束を、この記事では Telemetry Contract という言葉で表現します。

なお、Telemetry Contractという言葉は私の造語ではありません。
OpenTelemetry周辺でも、OBIのissue #1759やSIG End Userのissue #332などで、この言葉や近い考え方が使われています。
また、OpenTelemetryのVersioning and Stabilityにも、producerとconsumerの間で互換性を扱う考え方があります。

一方で、Telemetry ContractがOpenTelemetryで統一された正式な用語として定義されているわけではなく、その意味も一つに定まっているわけではありません。

そこでこの記事では、

producerがconsumerに何を提供し、何を維持すると約束するか

という意味でTelemetry Contractを使います。

決めた約束をどうやって維持するか

ここでいうContractは、YAMLなどの定義ファイルそのものではありません。定義ファイルは、約束のうち機械で表現できる部分を記述する手段です。

ただ、約束を決めるだけでは十分ではありません。

名前や型、単位、属性について「これは維持する」と決めても、それが人向けのドキュメントにしか書かれていなければ、実装の変更とずれていく可能性があります。
変更のたびに人が確認するだけでは、見落としも起こります。

そこで、約束のうち機械で表現できる部分だけでも、共通の定義として持てないかと考えました。

その定義を、作るときの検証だけでなく、利用者向けのドキュメント生成、変更前後の比較、実装から送出されたテレメトリとの照合にも使えるのであれば、Telemetry Contractを維持するための仕組みとしてかなり使いやすくなりそうです。

このようなことができないか調べていて見つけたのがOpenTelemetry Weaverでした。

OpenTelemetry Weaverとは

OpenTelemetry Weaverは、機械可読なテレメトリの定義を扱うためのツール群です。

github.com

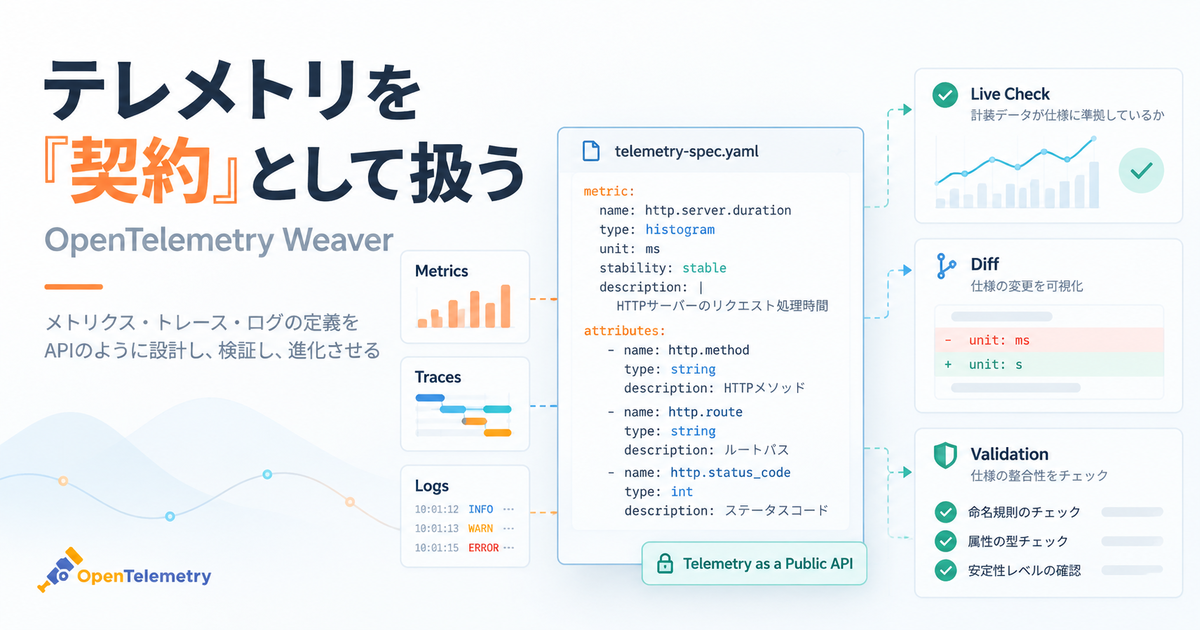
テレメトリを公開APIのように扱う

WeaverのREADMEには “Treat your telemetry like a public API”(テレメトリを、公開APIのように扱う) とあります。
ここまで考えてきた「利用者が依存するテレメトリにも互換性がある」という話と、かなり近い発想です。

OpenTelemetryの公式ブログでも、この考え方は「Observability by Design」として説明されています。
Observabilityをデプロイ後に考えるのではなく、ソフトウェア開発の初期から設計対象にし、テレメトリを公開APIのように扱うという考え方です。
メトリクス名の変更によって既存のアラートやダッシュボードが壊れることも、その背景にある問題の一つとして挙げられています。
Observability by Design: Unlocking Consistency with OpenTelemetry Weaver | OpenTelemetry

Weaverでは、テレメトリの定義を検証したり、独自のルールを適用したり、定義からドキュメントなどを生成したりできます。
定義の変更を比較する機能や、実際に送られてきたテレメトリを定義と照合する live-check もあります。

Telemetry Contractを維持する仕組みとして使えるか

私が気に入ったのは、これらを個別の機能として使えることだけではありませんでした。
テレメトリについて「何を提供し、何を維持するのか」を機械可読な定義として表現し、その定義を作成時の検証、変更時の確認、送出されたテレメトリとの照合など、複数の場面で共通の基準として使えるのであれば、 Telemetry Contractを維持する仕組みとして使えるのではないか、と考えました。

一方で、Weaverが「何を約束すべきか」まで決めてくれるわけではありません。
何をTelemetry Contractに含めるのか、どの変更を互換性のない変更として扱うのかは、提供する側と利用する側で決める必要があります。

そこで今回は、WeaverをTelemetry Contractそのものとして見るのではなく、Telemetry Contractのうち機械で表現できる部分を、実際に複数の工程で使えるのかという観点から試してみました。

Weaverでどこまで扱えるか

ここまで、Telemetry Contractのうち機械で表現できる部分を、Weaverを使って複数の工程で利用できるのではないか、と考えてきました。

実際にどこまでできるのか、いくつかの小さな定義を使って試してみます。

今回試した環境と結果

今回の検証では、すべて OpenTelemetry Weaver v0.26.1 を使っています。

先に結果をまとめると、次のようになりました。

# 試したこと 確認できたこと 今回見えた境界
1 機械で読める定義を用意する metricやattributeなどを構造化して定義できた definition/2 はv0.26.1では not yet stable
2 定義を検証する schema errorや壊れた参照を検出できた diagnosticsだけで常に修正箇所まで特定できるわけではない
3 独自ルールを適用する Regoで自分たちのルールを評価できた 何を違反とするかは利用する側で決める
4 同じ定義から成果物を生成する MarkdownやJSONを生成できた 利用者向けの見せ方はtemplate側で考える必要がある
5 変更を確認する 定義の追加・削除を registry diff で確認できた 今回試した一部のフィールド変更は registry diff に現れなかった
6 互換性のルールを評価する 独自policyで型、単位、instrumentなどの変更を違反にできた 何を互換性のない変更とするかは自分たちで決める
7 送出されたテレメトリと照合する live-check で型の不一致や一部のrequired attribute欠落などを検出できた signalによって確認できる範囲が違った

なお、以下の検証は、一つの定義を最初から最後まで通したものではありません。それぞれ目的に合わせた小さなfixtureを使って確認しています。

以下では、表の順に実際に試した内容を見ていきます。

1. 機械で読める定義を用意する

最初に、テレメトリをWeaverで扱える形にしてみます。

小さな決済サービスを定義する

ここでは架空の決済サービスを用意しました。

実際に使った定義から、今回の話に必要なところだけ抜き出すと次のようになります。

attributes:
  - key: example.payment.method
    type:
      members:
        - id: card
        - id: bank_transfer
    stability: development

metrics:
  - name: example.payment.processed
    instrument: counter
    unit: "{payment}"
    stability: development
    attributes:
      - ref: example.payment.method

この定義には、メトリクスの名前だけでなく、計測方法、単位、安定性、利用する属性などが記述されています。

例えば example.payment.processed は counter であり、example.payment.method という属性を利用する、といった情報です。

前に話していたTelemetry Contractのうち、機械で表現できる部分を、このような形で記述していくことになります。

なお、今回使った definition/2 は、Weaver v0.26.1では正常に利用できましたが、実行時に次のwarningが表示されました。

File format `definition/2` is not yet stable

そのため、今回の検証では利用できたものの、安定した形式として扱える段階ではない点には注意が必要です。

2. 定義を検証する

定義を機械で読める形にしたら、まず期待したのは、おかしな定義をそのまま使わせないことでした。

壊れた参照を入れてみる

例えば、メトリクスから存在しない属性を参照するように定義を変更します。

attributes:
  - ref: example.payment.nonexistent

Weaver v0.26.1で、存在しない属性を参照する定義に対して registry check を実行すると、次のようになりました。

$ weaver registry check -r bad-reference --v2

The following attribute reference is not resolved for the group
'metric.example.payment.processed'.
Attribute reference: example.payment.nonexistent
Provenance: .../model/payment.yaml

このときexit codeは1です。
対象となるmetric、存在しない属性名、定義ファイルまで確認できます。

このほか、必須の type を削除した場合には、

Missing required property: "type".

としてschema errorも検出されました。

少なくとも今回試した範囲では、定義の構造や参照関係がおかしくなっていないかを、利用者へ届く前に確認できます。

一方、すべてのdiagnosticがYAML上の正確な行番号まで示してくれるわけではありませんでした。
小さな定義では十分追えましたが、registryが大きくなった場合の使い勝手は別に確認した方がよさそうです。

3. 独自ルールを適用する

schemaとして正しいだけでは、利用者との約束を守れているとは限りません。

次に、自分たちで決めたルールをWeaverで評価できるかを試しました。

Regoでルールを書いてみる

検証用に、

example.payment.* の属性の説明には payment という言葉を含める

という単純なルールを用意しました。

Weaverでは、このような独自ルールをRegoで記述できます。今回使ったルールは次のようなものです。

package after_resolution

import rego.v1

deny contains finding if {
  # 定義されている属性を一つずつ確認する
  attr := input.registry.attributes[_]

  # example.payment.* の属性だけを対象にする
  startswith(attr.key, "example.payment.")

  # 説明文に "payment" が含まれていなければ違反とする
  not contains(lower(attr.brief), "payment")

  finding := {
    "id": "example_payment_brief_must_identify_payment",
    "message": sprintf(
      "Attribute %s must mention payment in its brief.",
      [attr.key]
    ),
    "level": "violation"
  }
}

after_resolution では、Weaverが読み込んで解決したregistryを input.registry から参照できます。
このルールでは、その中にあるattributeを順に見て、example.payment.* で始まるattributeの説明に payment が含まれていなければ violation を返しています。

試しに example.payment.amount の説明から payment を取り除き、Weaver v0.26.1で registry check を実行しました。

$ weaver registry check -r bad-description --v2 -p bad-description/policies

Attribute example.payment.amount must mention payment in its brief.

このときexit codeは1になりました。

ルールを決めるのはWeaverではない

ここで重要なのは、「説明には payment を含めるべきだ」というルールそのものをWeaverが決めたわけではないことです。

このルールを決めたのは私たちです。Weaverは、決めたルールと実際の定義を照らし合わせ、違反しているかを評価しています。

Telemetry Contractについても同じです。
何を利用者との約束として維持するのか。その約束を破る変更を何とするのか。そこは自分たちで決める必要があります。

Weaverが手伝ってくれるのは、一度決めたルールを機械的に評価し、変更のたびに確認できるようにするところです。

4. 同じ定義から成果物を生成する

次に試したのが、同じ定義を人が読むドキュメントなどの生成にも使えるかです。

templateからMarkdownを生成する

WeaverのForgeでは、registryの内容をtemplateへ渡して成果物を生成できます。

今回の検証では、まず次のようなMarkdown用のtemplateを用意しました。

# Example Payment Service telemetry

## Attributes
{% for attr in ctx.registry.attributes %}
- `{{ attr.key }}` ({{ attr.type }}): {{ attr.brief }}
{% endfor %}

## Spans
{% for span in ctx.registry.spans %}
- `{{ span.type }}` — {{ span.brief }}
{% endfor %}

## Metrics
{% for metric in ctx.registry.metrics %}
- `{{ metric.name }}` ({{ metric.instrument }}, `{{ metric.unit }}`) — {{ metric.brief }}
{% endfor %}

## Events
{% for event in ctx.registry.events %}
- `{{ event.name }}` — {{ event.brief }}
{% endfor %}

このtemplateを使って、Weaver v0.26.1でMarkdownを生成します。

$ weaver registry generate markdown generated/markdown \
    -r registry --v2 \
    -t templates \
    -p policies

生成されたMarkdownには、例えば次のような内容が含まれました。

# Example Payment Service telemetry

## Attributes

- `example.payment.amount` (double): The payment amount in the currency's major unit.

- `example.payment.currency` (string): The payment currency expressed as an ISO 4217 code.

- `example.payment.id` (string): A payment identifier.

- `example.payment.method` ({"members": [{"brief": "Payment by card.", "id": "card", "value": "card"}, {"brief": "Payment by bank transfer.", "id": "bank_transfer", "value": "bank_transfer"}]}): The payment method used.

## Metrics

- `example.payment.processed` (counter, `{payment}`) — The number of processed payments.

同じregistryに書いたattributeやmetricの情報を、人向けのMarkdownへ展開できています。

JSONの成果物も生成する

別のtemplateを用意すれば、同じregistryからJSONのような機械向けの成果物も生成できます。

今回の検証では、attribute、span、metricの名前だけを取り出すtemplateも用意しました。

{
  "attribute_keys": [{% for attr in ctx.attributes %}"{{ attr.key }}"{% if not loop.last %}, {% endif %}{% endfor %}],
  "span_types": [{% for span in ctx.spans %}"{{ span.type }}"{% if not loop.last %}, {% endif %}{% endfor %}],
  "metric_names": [{% for metric in ctx.metrics %}"{{ metric.name }}"{% if not loop.last %}, {% endif %}{% endfor %}]
}

これもWeaver v0.26.1で生成すると、

$ weaver registry generate jsonmeta generated/jsonmeta \
    -r registry --v2 \
    -t templates \
    -p policies

次のようなJSONになりました。

{
  "attribute_keys": ["example.payment.amount", "example.payment.currency", "example.payment.id", "example.payment.method"],
  "span_types": ["example.payment.process"],
  "metric_names": ["example.payment.processed"]
}

用途に応じてtemplateを用意すれば、同じテレメトリ定義から異なる形式の成果物を作れます。

今回の小さなfixtureでは、MarkdownとJSONをそれぞれ同じ入力から繰り返し生成したところ、各形式の生成結果はbyte単位で一致しました。
また、attributeの宣言順だけを入れ替えて再生成した場合も、今回の2つの成果物には差分がありませんでした。

生成物をGitで管理したり、CIで差分を確認したりする場合には使いやすそうです。

生成できることと、必要な意味が伝わることは別

一方で、先ほどのMarkdownを見ると気になるところがあります。

example.payment.method の型は、本来 card と bank_transfer を持つenumです。しかし、単純に {{ attr.type }} と出力すると、

{"members": [{"brief": "Payment by card.", "id": "card", "value": "card"}, ...]}

のように、内部構造に近い表現がそのまま出てきました。

これはWeaverが誤った情報を生成したという話ではありません。今回のtemplateで、enumを利用者向けにどう表現するかを何も指定していないためです。

同じ定義を使っていても、そこから何を取り出し、どう見せるかはtemplate側で決まります。

つまり、同じ定義から生成できることと、利用者に必要な意味が適切に伝わることは別です。

機械可読な定義を基準にすることで、定義とドキュメントを別々に手作業で管理する量は減らせそうです。一方で、「定義を一つにすれば、あとは自動生成ですべて解決する」とまでは言えません。

5. 変更を確認する

Telemetry Contractとして扱うなら、定義を変更したときに何が変わったのかも確認したいところです。

ここでは、先ほどの決済サービスとは別に、小さなstorage service相当のfixtureを使いました。

このfixtureには my.attr、attr2、my.span、my.metric などを定義しています。

追加と削除は registry diff で見えた

Weaver v0.26.1でattributeを追加した定義を比較すると、次のようになりました。

$ weaver registry diff --v2 \
    --registry candidate-additive \
    --baseline-registry baseline \
    --format json

{
  "registry_attributes": [
    {
      "type": "added",
      "name": "my.optional.region"
    }
  ],
  ...
}

attributeを削除した場合も、同じように変更を確認できます。

$ weaver registry diff --v2 \
    --registry candidate-remove \
    --baseline-registry baseline \
    --format json

{
  "registry_attributes": [
    {
      "type": "removed",
      "name": "attr2"
    }
  ],
  ...
}

attr2 を my.attr2 へ名前変更したケースでは、renameとして一つの変更になるのではなく、追加と削除として観測されました。

$ weaver registry diff --v2 \
    --registry candidate-rename \
    --baseline-registry baseline \
    --format json

{
  "registry_attributes": [
    {
      "type": "added",
      "name": "my.attr2"
    },
    {
      "type": "removed",
      "name": "attr2"
    }
  ],
  ...
}

定義の中身を変えた場合はどうなるか

次に、定義そのものは残したまま、中のフィールドだけを変更してみました。

例えば my.metric の instrument を、

counter → gauge

へ変更します。

Weaver v0.26.1と今回のfixtureでは、この状態で registry diff を実行しても結果は空でした。

同じ検証範囲では、

attribute type: int → string
metric unit:     {1} → ms
stability:       stable → development

といった変更も、それぞれのフィールドの変更として registry diff には現れませんでした。

ここは注意が必要です。

これは「Weaverの registry diff はフィールド単位の変更を検出できない」という一般的な性質を示したものではありません。Weaver v0.26.1と、今回試したfixture・変更内容では、この結果になったという観測です。

では、こうした変更をTelemetry Contract上の問題として検出したい場合はどうすればよいのでしょうか。

6. 互換性のルールを評価する

前節では、registry diff を使って定義の追加や削除を確認できました。

一方で、何が変わったのかを確認することと、その変更を許してよいか判断することは別の問題です。

そこで、変更前の定義をbaseline、変更後の定義をcandidateとして比較する独自のRego policyを用意しました。

フィールド単位の変更をpolicyで評価する

今回のpolicyでは、baselineとcandidateの同じ定義を比較し、型や単位、instrument などが変わっていたらviolationを返すようにしました。

例えばattributeの型を比較する部分は、概ね次のような形です。

old := data.registry.attributes[_]
new := input.registry.attributes[_]

old.key == new.key
old.type != new.type

data.registry がbaseline、input.registry がcandidateです。

同じ考え方でmetricの unit や instrument も比較します。

Weaver v0.26.1では、変更内容ごとにcandidateを用意してpolicyを適用しました。

例えば、attributeの型を int から string へ変更したケースでは、

Attribute attr2 type changed from int to string.

metricの unit や instrument を変更したケースでは、

Metric my.metric unit changed from {1} to ms.
Metric my.metric instrument changed from counter to gauge.

というfindingを確認できました。

これらは、いずれも今回用意したpolicyによって violation として評価されたものです。violationがある場合、registry check のexit codeは1になりました。

前節では registry diff に現れなかったフィールド単位の変更も、比較するルールを自分たちで定義すれば評価できることが分かります。

何を壊れたとみなすかはWeaverが決めない

ただし、ここは区別しておく必要があります。

counter から gauge への変更をviolationにしたのは、今回私が作ったpolicyです。

Weaver自身が、

counter から gauge への変更はTelemetry Contractを壊す

と判断したわけではありません。

単位の変更を許すのか。attributeの追加をどう扱うのか。stableなattributeの型変更を止めるのか。

何を互換性のない変更とするかは、利用者との間で「何を維持する」と約束したのかによって変わります。

Telemetry Contractで守る範囲を決め、その判断基準をpolicyとして表現すれば、Weaverを使って継続的に評価できます。

ContractとCIの運用も別の話

さらに、互換性のルールを決めても、まだ運用上の判断は残ります。

例えば、

  • どのviolationでCIを止めるのか
  • 一時的な例外を認めるのか
  • 例外を誰が承認するのか

といったことです。

これらは「利用者に何を約束するか」というTelemetry Contractそのものとは別に、組織として決めるpolicyや運用の話です。

Weaverは、決めたルールを機械的に評価するところまでを支援できます。

今回試してみて、変更を観測すること、互換性を判断すること、その判断をCIでどう運用するかは、それぞれ分けて考えた方がよいということがかなりはっきりしました。

7. 送出されたテレメトリと照合する

ここまでは、テレメトリの定義を作ったり変更したりするときの話でした。

しかし、定義が正しくても、実装がその定義どおりのテレメトリを送っているとは限りません。

そこで最後に、Weaverの live-check を使って、実験用に送出したテレメトリをregistryと照合してみました。

今回確認するのは、実験用に送出したテレメトリをregistryと照合できるかです。本番環境での常時監視までを検証するものではありません。

live-check では別のregistryを使う

この検証でも Weaver v0.26.1 を使っています。
ここでは、それまでの検証とは別に、live-check 用の小さなregistryを用意しました。このregistryはlegacy v1形式です。

なお、Weaver v0.26.1の live-check 自体はV2 schemaにも対応しています。そのため、以下の結果は「live-check はv1でなければ使えない」という意味ではありません。

架空のcheckout serviceとして、spanの example.checkout.process、eventの example.checkout.process、metricの example.checkout.total などを定義しています。
主なattributeは次のとおりです。

example.checkout.id      string / required
example.checkout.method  enum(card, cash)
example.checkout.total   double

live-check はOTLP receiverとして起動し、そこへ実験用のスクリプトからtrace、log、metricを送ります。

今回使った起動方法は、概ね次のようなものです。

$ weaver registry live-check \
    -r registry \
    --input-source otlp \
    --otlp-grpc-address 127.0.0.1 \
    --otlp-grpc-port 54317 \
    --admin-port 54320 \
    --format json \
    --output http \
    --fail-on violation

Weaver v0.26.1では、今回OTLP/gRPCでtrace、log、metricを受信できました。

型が違えば検出された

まず、registryでは、

example.checkout.total: double

と定義しておきます。

そこへ、example.checkout.total の値を文字列の "12.5" にしたspanを送ってみました。

実験用スクリプトから送信すると、live-check では type_mismatch のviolationとして検出されました。

$ python run.py type --signal span

Attribute 'example.checkout.total' has type 'string'.
Type should be 'double'.

reportには、実際の型が string、期待した型が double であることも含まれていました。

次に、送るtelemetryはまったく変えず、registry側の定義だけを、

double → string

へ変更します。

同じ "12.5" を送ると、今度は type_mismatch が出なくなりました。

$ python run.py type --signal span --registry registry-string

0 findings

少なくともこのケースでは、registryに書いた型が、送出したtelemetryを判定する基準として使われています。

required attributeはsignalによって結果が違った

一方で、何でも同じように確認できたわけではありません。

example.checkout.id をrequiredとして定義したうえで、実際に送るtelemetryからこのattributeを抜いてみました。

結果は次のようになりました。

送ったsignal required attributeを欠落させた結果
metric required_attribute_not_present
event_name を持つlog required_attribute_not_present
span findingなし

metricと、registryのevent名に対応する event_name を持つlogでは、required attributeの欠落がviolationとして検出されました。

一方、spanでは同じattributeを欠落させてもfindingは出ませんでした。

未定義のspan名も同じようには検出されなかった

spanについては、さらに名前の対応も確認しました。

registryには、

example.checkout.process
example.checkout.refund

という2つのspan definitionを用意しました。

そのうえで、registryに存在しないspan名も送ってみましたが、今回の検証では未定義span名に対するfindingは出ませんでした。

また、process と refund のどちらのdefinitionに対応付けられたのかを、reportから確認することもできませんでした。

Weaver v0.26.1のCLIにも、今回確認した範囲ではspan matcherを指定するoptionはありませんでした。

一方で、metricはmetric名、eventは event_name によってregistry上の定義と対応付けられていることを確認できました。

attributeの検証とsignal全体の検証は同じではない

ここは今回の live-check の検証で、特に注意したいところです。

spanに含まれる example.checkout.total の型が違えば、type_mismatch は検出されました。

しかし、それだけで、

このspanは example.checkout.process の定義全体に適合している

とまでは言えません。

今回のWeaver v0.26.1では、spanのrequired attribute欠落や未定義span名について、metricやeventと同じような結果にはなりませんでした。

つまり、個々のattributeをregistryと照合できることと、signal全体が特定のdefinitionに適合していることを確認できることは別です。

そのため、live-check を使えば「送出されたテレメトリが定義どおりであることをすべて確認できる」と考えるのは強すぎます。

それでも、registryで定義した型と実際の値の違いを検出でき、registry側の定義を変えると同じtelemetryに対する判定も変わりました。

今回試した範囲では、機械可読な定義を、送出されたテレメトリを確認するための基準として利用できることは確認できました。

今回わかったこと

ここまで実際に試してみて、Telemetry ContractとWeaverの関係がだいぶ整理できました。

WeaverがTelemetry Contractを決めるわけではない

まず、WeaverがTelemetry Contractそのものを決めてくれるわけではありません。

利用者に何を提供し、何を維持すると約束するのか。
メトリクス名を維持するのか。attributeの型や単位まで含めるのか。どの変更を互換性のない変更として扱うのか。

こうしたことは、提供する側と利用する側で決める必要があります。
Weaverは、その判断を代わりにしてくれるものではありません。

一方で、一度決めた約束のうち機械で表現できる部分については、定義の検証、独自ルールの評価、成果物の生成、変更の確認、送出されたテレメトリとの照合と、複数の工程で利用できました。

今回試してみて重要だと感じたのは、一つのYAMLファイルをそのまま使い回せることではありません。テレメトリの定義を、複数の工程で共通の基準として使えることです。

変更を見つけること、判断すること、止めることは別

今回特に印象に残ったのは、変更を見つけること、その変更が互換性のないものか判断すること、実際に変更を止めることは、それぞれ別だという点です。

registry diff で変更を確認できても、それが利用者との約束を壊す変更なのかは別に判断する必要があります。

独自policyでその判断基準を表現し、violationとして検出することもできます。

さらに、そのviolationでCIを止めるのか、例外を認めるのか、誰が承認するのかは、また別の運用上の判断です。

何を互換性のない変更とするのかは、Telemetry Contractで何を維持すると約束したのかをもとに決める必要があります。
その判断基準をpolicyとして表現し、CIや承認をどう運用するかは、その次の話です。

Weaverは、こうして決めたルールを継続的に評価するところを支援してくれます。

なお、今回はTelemetry Contract自体のライフサイクルまでは扱っていません。実際には、一度依存可能とした定義をどうdeprecatedにし、どの程度の移行期間を設け、いつ削除するのか、といった時間軸も設計する必要があります。今回は、Weaverでそのライフサイクルをどう管理するかまでは検証していません。

テレメトリが出ているだけでは十分ではない

最初に挙げた例では、メトリクス名を変更してもアプリケーションは動き続け、テレメトリも送られていました。

それでも、その名前に依存していたダッシュボードやアラートは壊れました。

テレメトリが出ていることと、利用者との約束を守れていることは同じではありません。

まず、誰に何を約束するのかを決める。

そのうち機械で表現できる部分を定義にする。

そして、その定義を作るときだけでなく、変更するときや、送出されたテレメトリを確認するときにも使う。

今回Weaverを試してみて、Telemetry Contractのうち機械で扱える部分を、複数の工程で共通の基準として利用できることが見えてきました。

まとめ

テレメトリは、出力できていればそれでよいわけではありません。利用者がその名前や型、単位、属性に依存しているなら、それらを不用意に変えることでダッシュボードやアラートを壊してしまいます。

そこでこの記事では、producerがconsumerに「何を提供し、何を維持すると約束するか」をTelemetry Contractとして考えました。

その約束のうち機械で表現できる部分を定義にし、OpenTelemetry Weaver v0.26.1で実際に試してみると、定義の検証、独自ルールの評価、成果物の生成、変更の確認、送出されたテレメトリとの照合と、複数の工程で利用できました。

一方で、何をTelemetry Contractに含めるのか、どの変更を互換性のない変更とするのかはWeaverが決めてくれるわけではありません。変更を見つけること、互換性を判断すること、その判断をCIなどでどう運用するかも、それぞれ分けて考える必要があります。

実際に取り入れるなら、最初からすべてのテレメトリを対象にするのではなく、利用者からの依存関係が把握しやすい、少数のメトリクスなどから小さく試してみるのがよさそうです。

Weaverを試してみて見えてきたのは、Telemetry Contractそのものを自動化することではなく、自分たちで決めた約束のうち機械で扱える部分を、テレメトリの定義を基準にして複数の工程で継続的に扱えることでした。

参考資料

ソフトウェア設計を「自由度の配置」として眺めてみる

はじめに

これは、ソフトウェア設計を「自由度の配置」という観点から眺めてみる、ひとつの思考実験です。

設計とは意思決定なのか

最近、ソフトウェア設計について考えるとき、「設計とは意思決定である」と捉えることが増えました。
設計では大小さまざまなことを決めていきます。データをどこに持つのか、APIをどのような形にするのか、どの責務をどのパッケージに置くのか。

では、意思決定とは具体的には何をしているのでしょうか。

これまでを振り返ってみると、複数あった選択肢から一つを選び、それ以外を選ばないと決める、ということを繰り返してきたように思います。
そう考えると、設計には、それまであった選択肢を閉じていく面がありそうです。

では、設計とは自由度を減らしていくことなのでしょうか。

決めると、いくつかの選択肢が閉じる

例えば、システムが使うデータベースを決めれば、実装者が機能ごとに好きなデータベースを選ぶ余地は小さくなります。
APIの形を決めれば、利用者はその形に沿って呼び出すことになります。パッケージ構成を決めれば、新しいコードをどこに置くかもある程度決まります。

設計する前には複数の可能性があり、設計した後にはその一部が選べなくなる。
この部分だけを見れば、設計は自由度を減らしていく作業に見えます。

ただ、すべてを設計者が決め切るとは限りません。

たとえばライブラリが利用者に設定項目を公開することもあります。サーバーで一つの挙動に固定せず、クライアントから指定できるようにすることもあります。
設計時には決めず、デプロイ時に環境に合わせて選べるようにすることもあります。

「ここでは決めず、別のところで決められるようにする」こと自体も、設計判断として扱えそうです。

自由度はどこに残されるのか

ここでいう自由度は、単純な選択肢の数ではありません。
その時点ではまだ固定されておらず、誰かが判断できる余地、くらいの意味です。
使い道のない設定項目が百個あっても、それだけでよい設計になるとは思いません。

では、自由度がどこに残されているかを、もう少し具体的に見てみます。

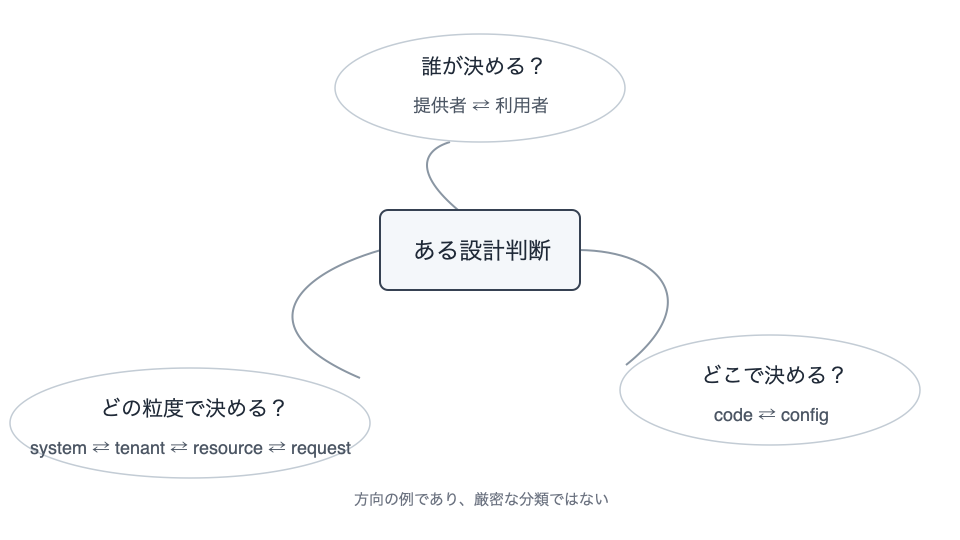
一つは、誰が決めるのかです。ライブラリの提供者が決めるのか、それを使うアプリケーションが決めるのか。チームで共通の方針を決めるのか、個々の実装者に任せるのか。

もう一つは、どこで決めるのかです。クライアントかサーバーか、コードか設定か、アプリケーションかデータベースか。同じ挙動でも、判断する場所が変われば、変更するときに触る場所や影響を受ける範囲が変わります。

粒度もあります。システム全体で一つに決めるのか、テナント単位で変えられるのか、リソースごとか、リクエストごとか。
細かい単位で決められるほど個別の事情には合わせやすくなりますが、システムの状態は一様ではなくなります。

これらを、自由度の分類としてきれいに整理したいわけではありません。
同じ設計判断を見ても、「誰が」「どこで」「どの粒度で」を変えて眺めると、何を固定し、何を残したのかが少し見えやすくなります。

図1: 自由度の配置を見る方向

いつ決めるか

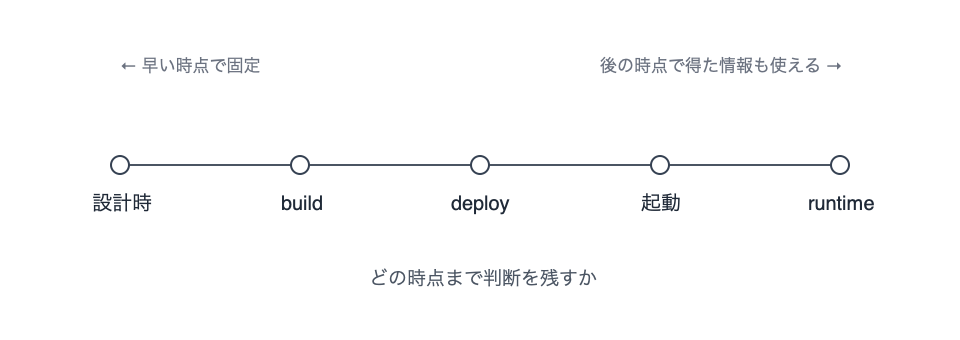
自由度には時間の方向もあります。

設計時に決めることもあれば、build時やdeploy時、起動時に決めることもあります。
runtimeになって初めて、そのときの入力や状態に応じて決まることもあります。

決定を後ろへ送れば設計時にはなかった情報を使えます。
例えば、デプロイ先の環境が決まってから接続先を選ぶ、リクエストの内容を見て処理を変える、といったことができます。

一方で、遅く決めるほどよいわけではありません。
runtimeに判断を残すと、実行時に複数の状態や分岐を扱う必要が出ることがあります。
確認すべき組み合わせが増えたり、問題が起きたときに「そのとき何が選ばれていたのか」を追う必要が出たりします。

いつ決めるかも、設計で選んでいることの一つです。

図2: 決定する時点

自由度を残すと、判断も残る

APIにoptionalなparameterを追加する場面を考えてみます。

これはそれまで提供側で一つに決めていた挙動を、利用者が選べるようにする変更です。
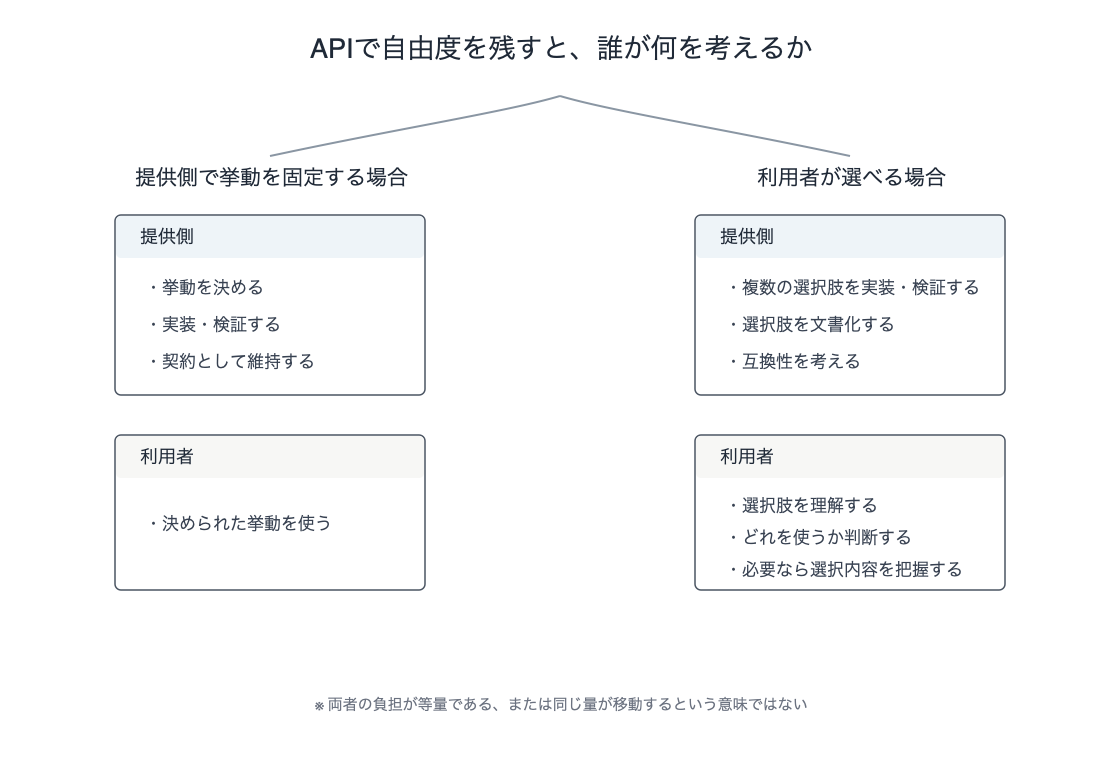
「APIが柔軟になった」と表現できますが、自由度の配置として見ると、提供側が引き受けていた判断の一部を利用者へ渡したとも言えます。

利用者は、どの値を指定すべきか理解して判断することになります。
提供側では、値ごとの挙動を検証し、使い方を文書に書き、公開した選択肢の互換性を考える必要が出てきます。
運用中に問題が起きたときは、どの値が使われていたかも調査対象になるかもしれません。

これは、自由度を増やすと同じ量の複雑さが必ず別の場所へ移る、という話ではありません。
うまい抽象化によって、利用者にも提供者にも分かりやすくなることはあります。また、利用者ごとに事情が違うなら、選べること自体に十分な価値があります。

それでも、自由度を残すならその自由度を誰がどう扱うのかは考えておきたいところです。
判断する人には必要な情報が届くのか、どこで検証するのか、増えた組み合わせをどこまで支えるのか、、、

図3: APIで自由度を残すと、誰が何を考えるか

制約によって考えなくてよくなることもある

APIで自由度を残す側を見ると、では自由度は少ない方がよいのか、とも思います。 では逆に、自由度を閉じることにはどんな意味があるのでしょうか。

gofmtやrustfmtのようなformatterは、コードをどう整形するかという自由度をかなり減らします。
書き手が読みやすいと思う形を毎回選ぶのではなく、決められた形へ機械的に揃えます。

ただし、その結果として失うものはあります。
好みの書き方ができなくなりますし、formatterの出力が常に自分の読みやすい形になるとも限りません。

一方で書式については毎回考えなくてよくなります。
レビューで空白や改行について議論する必要も減り、挙動や設計の差分へ注意を向けやすくなります。

もちろん制約そのものがよいわけではありません。
早すぎる固定や、事情の違う利用者を無理に一つへ揃えることは、別の不自由さを生むこともあります。

ただ、自由度には、選ぶための時間と注意が必要です。
あまり意味のない判断を制約で減らすことで、別の判断に注意を向けられる場合があります。

ADRに、残した自由度も書いてみる

設計を「自由度の配置」として捉えるこの思考実験を、実際の開発プロセスに当てはめてみるとどうなるでしょうか。
たとえば、設計判断の記録であるADR(アーキテクチャ・デシジョン・レコード)です。

ADRには通常、何を決めたのか、なぜそう決めたのかを書きます。
それを「どの自由度を、なぜこの時点で閉じたのか」の記録として読むこともできます。

そうすると、決めたことだけでなく、まだ決めていないことも気になります。 例えば、次のように残した自由度を記録しておくのです。

  • 誰に残したか: 今回はシステム全体の方針だけを決め、個々の実装方法は各チームに残した。
  • いつまで残したか: 今は環境の情報が足りないので、接続先はdeploy時に決めることにした。
  • コード上でどう残したか: 将来の要件変更を見据え、現時点では特定のデータベースに依存させず、インターフェースのみ定義して技術選定の自由度を残した。

そうした「どこに自由度を残したか」も、後から設計判断を理解する重要な材料になります。

もちろん、すべての未決事項をADRへ書けばよいわけではありません。
少なくとも、意図して残した余地と、単に決め忘れたことを区別できると、その後の判断はしやすくなりそうです。

まとめ

この記事の冒頭で、「設計とは自由度を減らしていくことなのだろうか」と問いかけました。
ここまで考えてみると、その景色は少し違って見えます。

たしかに設計で何かを決めれば、いくつかの選択肢は閉じます。
しかし、すべての自由度がそこで消滅するわけではありません。利用者に委ねることもあれば、別の場所へ置くことも、あえて実行時まで遅らせることもできるのです。

そう考えると、私たちが設計で目を凝らすべきは「自由度の多い・少ない」だけではありません。
「誰に、どこに、いつ、どの粒度で判断を残すか」という、自由度の配置そのものなのかもしれません。

自由度を残せば、それを扱う人が判断するための情報や、検証、文書化、運用が必要になります。
逆に、あまり意味のない自由度をあえて閉じることで、より重要な判断にチームの注意を向けることもできるでしょう。

だからこそ「ここを柔軟にした方がよいか」と問われたとき、単に設定項目を増やすかどうかではなく、次のように問い直してみたいのです。

  • 誰が判断するのか
  • どこで判断するのか
  • いつ判断するのか
  • どの粒度で変えられるのか
  • その判断を誰がどう支えるのか

こう考えるだけで、今まさに何を選ぼうとしているのかが、少しクリアに見えてこないでしょうか。

もちろん、これは絶対的な設計レビューの手順でも、万能なチェックリストでもありません。何でも「自由度」という言葉で説明できるとも思っていません。
それでも、自分が「柔軟にしたい」と考えたとき、その柔軟さをどこに置こうとしているのかを捉えるための視点として、しばらく使ってみたいと思っています。

【余談】この記事の執筆について
現在、手元でAIを使った執筆環境を構築しており、この記事はその環境のドッグフーディングとして執筆しました。頭の中にあったぼんやりとした思考を、AIと壁打ちしながら言語化しています。

以上です。

いま議論しているのは問題か、解決策か

※この記事は、高知県の消防広域化に関するニュースを見たことをきっかけに考えたことをまとめたものです。私は高知県に住んでいるわけでも、消防行政に詳しいわけでもありません。
公開されている資料を読み、AIとあれこれ議論した内容をブログ向けに書き直しています。高知県や須崎市の判断そのものを評価する記事ではありません。

はじめに

先日、高知県が進めている消防の広域化について、須崎市が協議からの離脱を表明したというニュースを見ました。

newsdig.tbs.co.jp www.fnn.jp

当初は自治体間の合意形成やスケジュールを巡る対立だと思っていたのですが、公開資料や報道を追ううちに少し違った印象を受けるようになりました。
単なる進め方の問題ではなく、「県一消防」という解決策自体が、本来の問題を本当に解決できるのかという疑問が見えてきたからです。

この経緯を追う中で、ふと自分の仕事のことが頭をよぎりました。
問題を解決するために選んだはずの手段が、いつの間にか「何が何でも実現すべき目的」にすり替わってしまう——私自身、仕事の中で何度もこのような経験をしてきたからです。

手段が目的化すると、元の課題を問い直す意見すら「進行を阻む障害」に見えてしまいがちです。
かといって、異論が出るたびに議論を振り出しに戻すわけにもいきません。どこまで問い直し、どこから先を決めて進めるべきなのか。

本記事では、このニュースをきっかけに、普段の意思決定で意識している「これは後戻りできる決定か」という問いを交えながら、プロジェクトにおける「目的と手段」の扱い方について考えてみます。

進め方への懸念に見えたもの

県が解こうとしていた問題

高知県は、人口減少が進む中でも必要な消防力を確保するため、県内の常備消防組織などを一元化する計画を進めています。

県が示している主な課題は、次のようなものです。

  • 将来的な税収や消防本部の財源確保への懸念
  • 高齢化に伴う救急出動件数の増加
  • 南海トラフ地震などの大規模災害への対応
  • 小規模な消防本部における間接業務の負担
  • 郡部の消防本部における人材確保の難しさ

県は、総務や通信指令などの間接部門を集約し、そこで生まれた余力を現場へ振り向けることなどを広域化の効果として挙げています。
ここまでは、解決したい問題と、そのために選ばれた解決策との関係は比較的分かりやすく見えます。

www.pref.kochi.lg.jp

しかし、実際に計画を進める段階では、その進め方をめぐって懸念が示されていました。

須崎市が示していたのは、まず進め方への懸念だった

須崎市は、遅くとも2025年9月時点で、計画の進め方に懸念を示していました。
2025年9月17日時点の意見をまとめた県の会議資料では、給与体系や勤務体制などの調整事項を残したまま新組織を発足させることに懸念を示しています。

また、現在のスケジュールは性急すぎ、この状態では市議会や住民の理解を得ることも難しいと指摘していました。

高知県「高知県消防広域化基本計画あり方検討会 第3回通信・システム部会 資料」12ページ、PDF

この時点で表に出ていたのは、広域化そのものへの反対というより、調整事項を残したまま進むことや、スケジュールの速さに対する懸念でした。

懸念は、協議への参加そのものへ広がった

2026年5月の実務協議会では、須崎市から次のような確認が行われています。

  • 各論に対して不同意とすることは可能か
  • 協議会から離脱することは可能か
  • 離脱した場合、消防広域化重点地域の扱いはどうなるのか

高知県「第1回高知県消防広域化に関する実務協議会におけるご意見等」76ページ、PDF

これに対して県は、県内全市町村を消防広域化重点地域に指定しているものの、その指定は協議会への参加を強制するものではないと回答しています。

個別の論点だけでなく離脱の可否まで確認しており、進め方への懸念が、協議へ参加し続けるかどうかという判断につながり始めていたことがうかがえます。

問われ始めたのは、進め方ではなく解決策そのものだった

その後、9月3日の実務協議会で、須崎市長は協議からの離脱を表明しました。
翌日の報道では、楠瀬市長は次のように述べています。

「根本的なところの考え方の違いがございますので」

「個人的にも県一消防の目的、メリットが非常に不確かなものであると感じていた」

――須崎市・楠瀬耕作市長

出典:高知さんさんテレビ「浜田知事『お付き合いの仕方考えないと』 消防広域化計画から離脱の須崎市に不快感示す」(2026年9月4日)

さらに、県一消防を実現しても、いずれ人材確保が難しくなる段階が来るとの見方も示しています。ここで、問いの対象が変わっています。

  • それまで表に出ていたのは、広域化をどのような手順やスケジュールで進めるかという懸念
  • 離脱表明後に示されたのは、広域化によって本来の課題を本当に解決できるのかという疑問

問いは「広域化をどう進めるか」から、「この解決策で本当に問題を解けるのか」へ広がっています。

公開資料から言える範囲

もちろん、公開資料だけでは、自治体間で実際にどのような調整が行われていたのかまでは分かりません。

離脱という判断が妥当だったのかも、この記事では評価できません。また、これらの資料から「須崎市は当初から消防広域化そのものに反対していた」と判断することもできません。

公開資料から確認できるのは、次の二点です。

  • 遅くとも2025年9月時点で、須崎市が計画の進め方に懸念を示していた
  • 2026年9月の離脱表明後には、広域化の目的や効果に対する疑問も報じられた

この二つの間にどのような経緯があったのかは、公開資料だけでは断定できません。
それでも私には、進め方への違和感として表れていたものが、次第に「この解決策で本当に問題を解けるのか」という問いへ広がっていったように見えました。

この見え方が、自分の仕事で起きていることについて考えるきっかけになりました。

高知の事例から、プロジェクトの話へ

ここからは高知県の消防広域化をいったん離れ、あるクラウド移行プロジェクトを仮定して考えてみます。
消防広域化とシステム開発では前提も制約も異なりますが、問題を解決するために選んだ手段が、いつの間にか目的へ変わっていく構図には共通するものがあります。

このプロジェクトが始まり、進み、途中で異論が出て、改めて進む方向を決めるまでを順に追ってみます。

解決策が目的に変わるとき

例えば、障害対応や定期作業に時間がかかり、一部の担当者に作業が集中しているシステムがあるとします。
運用負荷を下げる方法としてクラウド移行が提案され、正式なプロジェクトになりました。

予算、担当者、移行対象、期限が決まると、会議の問いも変わります。

「どうすれば運用負荷を下げられるか」ではなく、「どうすれば期限内に移行を完了できるか」が中心になります。

実行には必要な変化です。ただ、その瞬間にクラウド移行は「問題を解くための案」から「完了させるべき仕事」へ姿を変えます。

プロジェクトは成功した。問題は残った

移行は予定通り完了しました。
対象のサーバーも機能も新しい環境へ移り、報告書の上ではプロジェクトは成功です。

ところが、運用担当者の作業はほとんど減っていません。
従来の手順をそのまま持ち込んだため作業量は変わらず、新しい環境の知識まで必要になりました。
旧環境との二重運用が残れば、管理対象はむしろ増えます。

そもそも負荷の原因は、インフラではなく、複雑な業務フローや頻繁な例外対応だったのかもしれません。

クラウド移行は実現しました。一方で、最初に解決したかった運用負荷は残りました。

移行の完了だけを基準にすれば、このプロジェクトは成功と評価できます。
しかし、運用負荷を下げるという当初の目的に照らせば、問題を解決できたとは言えません。
同じプロジェクトでも、何を基準に評価するかによって、その見え方は変わります。

では、なぜプロジェクトでは、当初の問題よりも解決策の進捗が評価の基準になりやすいのでしょうか。

測りやすいものが前に出る

解決策の進捗は、問題の改善よりも測りやすい傾向があります。

  • 解決策の進捗:移行したサーバー数、完了した機能、予定との差
  • 問題の改善:作業時間、障害対応の回数、属人化の程度

複数のチームが関わる場合、見ている指標も異なります。
基盤を担当するチームには移行完了が成果でも、アプリケーションを運用するチームには、その後の作業が減らなければ問題は解決していません。
それぞれが担当範囲では正しい指標を追っていても、組織全体の目的が抜け落ちることがあります。

前者は毎日確認できます。後者は、実際に運用するまで分からないことがあります。
測りやすい解決策が前に出て、測りにくい問題が後ろへ下がります。

「計画したものを実現できたか」と「問題を解決できたか」は、別々に確認しなければなりません。

では、この二つが入れ替わったことには、いつ気付けるのでしょうか。

その異論は、何に反対しているのか

説明を増やしても話が進まない

移行の途中で、誰かが「議論が足りない」と言ったとします。

進める側は説明不足だと考え、移行手順、障害時の対応、切り戻しの条件、移行後の体制を示します。それでも相手は納得しません。

その人が疑っているのは移行方法ではなく、「運用負荷の原因は本当にインフラなのか」という前提かもしれないからです。

一方はクラウドへ「どう移すか」を説明し、もう一方は「なぜ移すのか」を尋ねている。同じ会議で、別の問いについて話しています。

異論が向いている先

「議論が足りない」という言葉だけでは、何に異論があるのか分かりません。

  • 好みや選好の違い:採用された構成とは別の案を好んでいる
  • 情報の不足:判断に必要な説明や資料を受け取っていない
  • 進め方への異論:合意形成の方法やスケジュールに納得していない
  • 前提への異論:問題の捉え方や選んだ解決策に同意していない
  • 変更への抵抗:現在のやり方が変わることを避けたい
  • 合意事項の蒸し返し:新しい事情がないまま、判断済みの事項を再び議題にしている

情報不足なら情報を補い、進め方が問題なら合意の取り方を確認します。好みの違いなら判断基準に照らして決めます。

前提への異論だけは、説明を足しても解消しません。問題と解決策の関係そのものを確認する必要があります。

異論が正しいとは限らない

前提への異論が出たからといって、必ずプロジェクトを止めるべきだとは思いません。
異論が単なる好みや変更への抵抗である場合も、判断済みの話が理由なく蒸し返される場合もあります。

見るべきなのは、異論があること自体ではなく、その異論が何に向いているのかです。

異論を退ける場合にも、対象は確認しておきたいところです。
取り違えれば、問題設定への指摘まで抵抗として処理してしまいます。

では、前提への異論だと分かったとき、どこまで議論を戻せばよいのでしょうか。

戻るか、進むか

これは後戻りできる決定か

大きな意思決定をするとき、私は「これは後戻りできる決定か」を考えるようにしています。
実行前にすべての結果を予測することはできないからです。

  • どこまでなら試せるか
  • 何を確認してから次へ進むか
  • どの時点までなら元へ戻せるか
  • 戻すためにどれだけの時間と費用がかかるか
  • 一度失うと取り戻しにくいものは何か

一部を移行して結果を見るなら、比較的後戻りしやすいでしょう。すべてのデータを一度に移し、同時に旧システムも止めるなら、簡単には戻れません。

後戻りしにくい決定ほど、その手前で「何を解決するための変更なのか」を問い直す意味が大きくなります。

大きな決定を小さく分ける

クラウド移行も、複数の決定に分けられる場合があります。

  1. 検証環境で技術的に実現できるか確認する
  2. 一部の利用者や機能を対象に試す
  3. 結果から本格移行するか判断する
  4. 残りを移行する
  5. 旧環境を停止する

前の決定で得た情報を、次の判断材料にできます。

ただし、小さく試せば必ず戻れるわけではありません。一定の規模がなければ効果を測れないことも、技術的には戻せても利用者への影響を取り消せないこともあります。

「戻せるか」だけでなく、「何を、どこまで戻せるか」を確認する必要があります。

戻る道にも期限を置く

後戻りできる状態を保つことにもコストがあります。二重運用が続けば、データ同期、二つの環境の監視、例外的な運用、担当者の確保といった負担が発生します。

選択肢を残し続けることが、新しい目的になってはいけません。戻る道を用意するなら、終了条件も決めます。

  • どこまで試すか
  • いつ結果を確認するか
  • 何を基準に次を決めるか
  • どの条件を満たしたら旧環境を閉じるか

期限を置くときは、その期限までに何を決めるのかも明確にします。

12月までに検証し、その結果で移行するか判断する

これは判断の期限です。

12月に移行すると決めたので、検証結果に関係なく進める

こちらは実行の期限です。外部サービスの終了などで時期を動かせないなら、この決め方もあり得ます。ただし、その場合の検証は、移行の可否ではなく、決まっている移行を安全に行う方法を探すものになります。

問い直したら、決めて進む

同じ解決策を、もう一度選ぶ

問題設定を問い直すことは、慎重であり続けることではありません。判断を遅らせる間にも費用は発生し、古いシステムを維持することにも損失があります。決めないことも中立ではありません。

問い直した結果、最初のクラウド移行をもう一度選ぶこともあります。その前に、解決したい問題、結果の確かめ方、実行条件、戻り方、先送りするコストを確認します。

確認して元の案を選ぶなら、その後は実装や移行へ進みます。問い直すのは、止めるためではなく、何を確かめながら進むのかを揃えるためです。

正しい問題を正しく解く

何を問題と捉えるかによって、選ぶ解決策は変わります。

  • 古いシステムが残っているなら、新しいシステムへ移行する
  • 運用負荷が高いなら、作業の自動化や手順を見直す
  • 使われていない機能を保守しているなら、その機能を廃止する
  • 変更に時間がかかるなら、テストやリリースの仕組みを改善する
  • 特定の担当者に依存しているなら、作業と知識を共有する

問題設定が変われば、当然に見えていた解決策も候補の一つに戻ります。

一方、正しい問題を選ぶだけでは状況は変わりません。解決策を実行し、その後に問題がどれだけ改善されたかを確認する必要があります。

「正しく解く」には、問い直すことだけでなく、実行と確認までが含まれます。

個人の問いを、組織の仕組みにする

個人が問題へ立ち戻るだけでは、その人がいない場面で同じ判断ができません。組織として扱うなら、意思決定の時点で次のことを記録します。

  • 解決しようとしている問題と、判断時点の前提
  • 選んだ解決策と、選ばなかった選択肢
  • 問題が改善したと判断するための指標
  • 判断を見直す条件
  • 撤退や切り戻しの条件

アーキテクチャ・デシジョン・レコード(ADR)などに残す方法もありますが、形式よりも、後から決定への反対と前提の変化を区別できることが大切です。

小さく試す場合も、進む条件と止める条件を先に決めます。問い直す場所を意思決定の中に作ることで、異論を受け止めながら、いつまでも決められない状態も避けやすくなります。

自分の仕事へ戻して考える

高知県の消防広域化とシステム開発では、前提も制約も異なります。それでも、進め方への異論が解決策そのものへの疑問を含むという見え方は、自分の仕事にも重なりました。

実行力があるチームほど、選んだ解決策を速く完成させられます。しかし、問題設定がずれていれば、解決しなくてよい問題まで速く解いてしまいます。

問題に戻るのは、前へ進まないためではありません。進む方向を確かめ、改めて決めるためです。

まとめ

この記事では、高知県の消防広域化をめぐって、須崎市が協議からの離脱を表明したことをきっかけに、プロジェクトにおける問題と解決策の関係について考えました。

公開資料や報道を追うと、進め方への懸念に見えたものが、やがて「県一消防で本来の課題を解決できるのか」という問いへ広がったように見えました。そこから、架空のクラウド移行プロジェクトを例に、仕事の中でも起こり得ることを考えました。

  • 解決策は、途中から実現すべき目的へ変わることがある
  • 測りやすい解決策の進捗と、本来の問題が改善したかは分けて確認する
  • 異論をそのまま採用する必要はないが、何に向けられた異論かは見分ける
  • 前提を問い直す範囲を考えるとき、「後戻りできる決定か」が判断材料になる
  • 戻る選択肢にもコストがあるため、試す範囲と判断の期限を決める
  • 問題や前提、見直す条件を記録し、問い直しを個人だけに依存させない

私がこの記事を書きながら至った結論は、問題設定を問い直すことと、決めて進むことは対立しないということです。

最後に残るのは、次の三つの問いです。

  • いま議論しているのは問題なのか、それともすでに選んだ解決策なのか
  • その解決策によって、最初にあった問題が改善したことをどう確認するのか
  • これは後戻りできる決定か

必要に応じて問題に立ち戻り、進む方向を確かめる。そのうえで決めて進み、結果を見ていく。そうした往復を意識することが、「正しい問題を正しく解く」ことにつながるのではないかと思います。

最後に

次に高知に行くチャンスがあれば鍋焼きラーメンを食べにいきたいです。

sta2020.com

参考資料

otlp-http-spyでOTLP/HTTPの内容を目視する

はじめに

OpenTelemetryを活用した分散トレーシングやメトリクス収集が広がる中、OTLP/HTTP通信の内容を詳細に確認したいという場面がちょいちょいあります。

例えばさくらのクラウドのモニタリングスイートというサービスではログをOTLP/HTTPで送信可能です。

manual.sakura.ad.jp

このモニタリングスイートと連携する時にどのようなリクエストを送っているのかだとかレスポンスの具体的な内容だとかを確認したいケースがあったりします。

これを簡単に行うためにOTLP/HTTPでのリクエスト/レスポンスを可視化する軽量プロキシツール otlp-http-spy というのを作ったのでご紹介します。


otlp-http-spyとは?

otlp-http-spyは、OpenTelemetry Protocol (OTLP) のHTTP通信を監視し、リクエストとレスポンスの内容を人間が読みやすいJSON形式で標準出力に表示する軽量なHTTPプロキシです。これにより、OTLP/HTTPを利用したログ、トレース、メトリクスのデータフローを容易にデバッグできます。

主な特徴は以下の通りです:

  • OTLP/HTTPエンドポイントのサポート:/v1/logs、/v1/traces、/v1/metrics に対応
  • ProtobufペイロードのJSON変換:バイナリ形式のProtobufデータをJSONに変換し、内容を可視化
  • リクエストとレスポンスのロギング:HTTPヘッダーとボディの両方を詳細に記録
  • 上流エンドポイントへの転送:受信したリクエストを指定したバックエンドに転送
  • 環境変数による設定:動作設定を環境変数で簡単に変更可能
  • 軽量なDockerイメージ:マルチアーキテクチャ対応のDockerイメージを提供

GitHub:https://github.com/yamamoto-febc/otlp-http-spy

github.com

なぜ作ったの?

=== 2024/04/01 : WHYを書いてなかったので追記

OpenTelemetry Collectorもエスクポート時のエラーくらいは表示してくれているのですが、例えば以下のような表示でどのようなエラーかは表示してくれずでした。

otel-collector-1  | 2025-03-31T01:39:13.094Z error   exporterhelper/retry_sender.go:145  Exporting failed. The error is not retryable. Dropping data.    {"kind": "exporter", "data_type": "logs", "name": "otlphttp", "error": "Permanent error: error exporting items, request to (バックエンドのURL)/v1/logs responded with HTTP Status Code 500", "dropped_items": 1}

上記の場合実はバックエンド側で↓のようなエラーが出ている状況だったのですがここから気づくのは無理ゲーでした... (以下の出力はotlp-http-spyからの出力)

=== Forwarded Response Headers ===

HTTP/2.0 500 Internal Server Error
Content-Length: 57
Content-Type: text/plain; charset=UTF-8
Date: Mon, 31 Mar 2025 01:39:13 GMT
(中略)

=== Raw Response ===

Unknown error: Timestamp is too old. 1970-01-01T00:00:00Z

OpenTelemetry Collectorが詳細なエラー出力をしてくれれば良いのですが、現時点ではOTLP/HTTPエクスポーターはエクスポーターがどのようなリクエスト/レスポンスをやりとりしたのかを出力する術を持っていないようでした。最初はOTLP/HTTPエクスポーターのHTTPクライアントのTransportにリクエスト/レスポンスをダンプするようなRoundTripperを噛ませようとしたのですが、OTLP/HTTPエクスポーターのコードに手を入れるよりは別途プロキシを作った方が楽という判断でした。

=== 2024/04/01追記ここまで


OpenTelemetry Collectorとの連携例

otlp-http-spy を OTLP/HTTPを受け付けるバックエンドの前段に挟むことで、バックエンドに送られる前のOTLP/HTTPリクエストやレスポンスを可視化できます。

[アプリケーション]
       |
       v
[OpenTelemetry Collector]
       |
       v
[otlp-http-spy]  ←★ リクエストをログにダンプ
       |
       v
[モニタリングスイートなどのOTLP/HTTPを受け付けるバックエンド]

この構成では、アプリケーションは OTLP/gRPCなどでOpenTelemetry Collectorにエクスポートし、OpenTelemetry Collectorがotlp-http-spy に対しOTLP/HTTP でエクスポート、otlp-http-spy はそのリクエストをダンプしつつバックエンドにフォワードします。

Collectorの設定例

Collector 側では、通常の otlp receiver を使い、Exporter に otlp-http-spy を示すために otlphttp/spy というエイリアス名を使うと分かりやすくなります。

receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

processors:

exporters:
  debug:
    verbosity: detailed
  otlphttp/spy:
    endpoint: http://localhost:4318
    compression: none

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: []
      exporters: [debug, otlphttp/spy]

    metrics:
      receivers: [otlp]
      processors: []
      exporters: [debug, otlphttp/spy]

    logs:
      receivers: [otlp]
      processors: []
      exporters: [debug, otlphttp/spy]

インストールと実行方法

Dockerを使用する場合

docker run --rm -p 4318:4318 -e ENDPOINT=https://your-otlp-http-backend ghcr.io/yamamoto-febc/otlp-http-spy:latest

GitHub Releasesからダウンロードする場合

以下から任意のプラットフォーム向けの実行ファイルをダウンロード

github.com

ENDPOINT=https://your-otlp-http-backend  otlp-http-spy

go installする場合

go install github.com/yamamoto-febc/otlp-http-spy@latest

ENDPOINT=https://your-otlp-http-backend  otlp-http-spy

ログ出力例

===> Received OTLP request:  /v1/logs

=== HTTP Request Headers ===
POST /v1/logs HTTP/1.1
Host: localhost:4318
Content-Type: application/x-protobuf

=== OTLP Message (Request) ===

{
  "resourceLogs": [
    ...
  ]
}

=== Forwarded Response Headers ===
HTTP/1.1 200 OK
Content-Type: application/x-protobuf

=== OTLP Message (Response) ===

{
  "partialSuccess": {
    "rejectedLogRecords": 0
  }
}

おわりに

otlp-http-spyは、OTLP/HTTP通信の内容を詳細に確認し、OpenTelemetryのデバッグを効率化するためのツールです。OTLP/HTTPでの通信を人が読める形でダンプすることでOpenTelemetry Collectorやバックエンドが受け取る前のリクエストやレスポンスを直接観察できます。開発中のプロジェクトではありますが、実用性のある最小限の機能がすでに利用可能です。

ぜひ試してみて、フィードバックなどお寄せください!

github.com

ウェブアクセラレータのアクセスログをSQLで集計してみた(clickhouse-local編)

ウェブアクセラレータでアクセスログのアップロード機能が提供開始されました。

www.sakura.ad.jp

これはウェブアクセラレータのアクセスログをさくらのクラウドのオブジェクトストレージにアップロードしてくれる機能です。

オブジェクトストレージにファイルがあれば clickhouse-localなどを用いてSQLが投げれるはず、ということで早速試してみました。

(※ 免責: 掲載内容は私自身の個人的な見解であり、必ずしも所属する企業や組織の立場、意見を代表するものではありません)

準備1: オブジェクトストレージへアクセスログをアップロードするための設定

まずはマニュアルに従ってオブジェクトストレージとウェブアクセラレータの設定を行います。

manual.sakura.ad.jp

manual.sakura.ad.jp

設定したらログがアップロードされるまでしばらく待ちます。 (現在の仕様だと1時間ごとにアップロードされるようです)

準備2: SQLを投げるための準備(clickhouse-local)

今回は clickhouse-localを用います。

clickhouse.com

認証情報の準備(AWSプロファイル)

認証のために~/.aws配下にconfigとcredentialを登録しておきます。

$ vi ~/.aws/config

[default]
region = jp-north-1
output = json
endpoint_url = https://s3.isk01.sakurastorage.jp

$ vi ~/.aws/credentials

[default]
aws_access_key_id = {発行したオブジェクトストレージへのアクセスキーID}
aws_secret_access_key = {発行したオブジェクトストレージのシークレットアクセスキー}

clickhouse-localの実行

今回はdockerで実行します。

$ docker run -it --rm -v $HOME:/root/ clickhouse/clickhouse-server:latest clickhouse-local -m

SQLを投げてみる

以下のようなSQLでアクセスログにクエリすることができます。

SELECT *
    FROM s3(
        'https://{バケット名}.s3.isk01.sakurastorage.jp/アクセスログのオブジェクトのパス',
        'JSONEachRow'
    ) ;

バケット名がexample、アクセスログのオブジェクトへのパスが sakura-webaccelerator/example.user.webaccel.jp/2024/11/27/access-20241127T13.log.gzの場合は以下のようになります。

SELECT *
    FROM s3(
        'https://example.s3.isk01.sakurastorage.jp/sakura-webaccelerator/example.user.webaccel.jp/2024/11/27/access-20241127T13.log.gz',
        'JSONEachRow'
    ) ;

なおバケット内にアクセスログしか置いていないなら以下のようにしてもOKです。

SELECT *
    FROM s3(
        'https://{バケット名}.s3.isk01.sakurastorage.jp/**.gz',
        'JSONEachRow'
    ) ;

利用できるワイルドカードについてはこちらを参照ください。

clickhouse.com

結果確認

私の環境だと以下のような結果となりました(一部情報を加工してマスクしてます)

   ┌─time──────────────────────┬─http_host─────────────────┬─scheme─┬─remote_addr───┬─remote_port─┬─remote_user─┬─request───────────────────┬─status─┬─bytes_sent─┬─body_bytes_sent─┬─referer───────────────────────────┬─x_cache─┬─msec───────────┬─request_id───────────────────────┬─user_agent────────────────────────────────────────────────────────────────────────────────────────────────────────────┐
1. │ 2024-11-27T13:28:34+09:00 │ xxx.user.webaccel.jp      │ http   │ 192.0.2.1     │ 46145       │             │ GET / HTTP/1.1            │ 200    │ 3590       │ 3068            │                                   │ MISS    │ 1732681714.282 │ xxx                              │ Mozilla/5.0 ...                                                                                                       │
2. │ 2024-11-27T13:28:34+09:00 │ xxx.user.webaccel.jp      │ http   │ 192.0.2.1     │ 46145       │             │ GET /index.html  HTTP/1.1 │ 200    │ 1376       │ 855             │ http://example.user.webaccel.jp/  │ MISS    │ 1732681714.518 │ xxx                              │ Mozilla/5.0 ...                                                                                                       │
3. │ 2024-11-27T13:28:35+09:00 │ xxx.user.webaccel.jp      │ http   │ 192.0.2.1     │ 46145       │             │ GET / HTTP/1.1            │ 200    │ 3590       │ 3068            │                                   │ MISS    │ 1732681715.550 │ xxx                              │ Mozilla/5.0 ...                                                                                                       │
4. │ 2024-11-27T13:28:35+09:00 │ xxx.user.webaccel.jp      │ http   │ 192.0.2.1     │ 46145       │             │ GET /style.css HTTP/1.1   │ 200    │ 1376       │ 855             │ http://example.user.webaccel.jp/  │ MISS    │ 1732681715.659 │ xxx                              │ Mozilla/5.0 ...                                                                                                       │
   └───────────────────────────┴───────────────────────────┴────────┴───────────────┴─────────────┴─────────────┴───────────────────────────┴────────┴────────────┴─────────────────┴───────────────────────────────────┴─────────┴────────────────┴──────────────────────────────────┴───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┘

DESCRIBEした結果はこんな感じでした。

    ┌─name────────────┬─type─────────────┬─default_type─┬─default_expression─┬─comment─┬─codec_expression─┬─ttl_expression─┐
 1. │ time            │ Nullable(String) │              │                    │         │                  │                │
 2. │ http_host       │ Nullable(String) │              │                    │         │                  │                │
 3. │ scheme          │ Nullable(String) │              │                    │         │                  │                │
 4. │ remote_addr     │ Nullable(String) │              │                    │         │                  │                │
 5. │ remote_port     │ Nullable(String) │              │                    │         │                  │                │
 6. │ remote_user     │ Nullable(String) │              │                    │         │                  │                │
 7. │ request         │ Nullable(String) │              │                    │         │                  │                │
 8. │ status          │ Nullable(String) │              │                    │         │                  │                │
 9. │ bytes_sent      │ Nullable(String) │              │                    │         │                  │                │
10. │ body_bytes_sent │ Nullable(String) │              │                    │         │                  │                │
11. │ referer         │ Nullable(String) │              │                    │         │                  │                │
12. │ x_cache         │ Nullable(String) │              │                    │         │                  │                │
13. │ msec            │ Nullable(String) │              │                    │         │                  │                │
14. │ request_id      │ Nullable(String) │              │                    │         │                  │                │
15. │ user_agent      │ Nullable(String) │              │                    │         │                  │                │
    └─────────────────┴──────────────────┴──────────────┴────────────────────┴─────────┴──────────────────┴────────────────┘

項目の詳細は以下にドキュメントがありますのでこれを見ながら色々すれば良さそうです。

manual.sakura.ad.jp

これを使えばアクセス数ランキングを出したり、キャッシュにヒットしなかったリクエストの割合を数えたりと色々できそうです。

アクセス数集計の例:

SELECT COUNT(*) as count, request
    FROM s3(
        'https://{バケット名}.s3.isk01.sakurastorage.jp/**.gz',
        'JSONEachRow'
    ) 
GROUP BY request
ORDER BY count DESC
;


   ┌─count─┬─request───────────────────┐
1. │     2 │ GET / HTTP/1.1            │
2. │     2 │ GET /news/sp.php HTTP/1.1 │
   └───────┴───────────────────────────┘

終わりに

ということでウェブアクセラレータのアクセスログをオブジェクトストレージにアップロードしつつSQLを投げてみました。
今回は以上です。

Working Backwards - プレスリリースから始める社内勉強会

この記事はさくらインターネット Advent Calendar 2023 5日目の記事です。

こんにちは、さくらインターネットの山本です。去年に引き続きSRE室という部署で働いています。

最近は

  • 某プロダクトのOpenTelemetry対応の一環としてSigNozを試験導入/運用
  • ログ解析基盤のDBをMariaDBからClickHouseに移行
  • 新規プロダクトチームへスクラムを導入
  • チームが自立自走できるようにするためのチーム運営支援

というあたりを担当しておりました。

今回の記事について

今回はチーム運営支援の一環としてファシリテーション/ファシリテーショングラフィックについての社内勉強会を企画した時にWorking Backwardsという考え方を取り入れてみたのでその体験談を投稿いたします。

「Working Backwards」とは

Working Backwardsとはこちらの記事によると

Working Backwardsでは「お客様は誰ですか?」 から始まる5つの質問を通じて、本当に必要なサービスを企画・開発していく。
具体的にはプレスリリースを書くことでこれからつくるプロダクトやサービスを明確にし、FAQを作成することでより具体的な体験として考えるための手法である。
(引用元: Amazonのイノベーションを支える「Working Backwards」とは?)

とのことです。

ファシリテーション勉強会を開催するにあたり@zembutsuさんに相談したところこの手法を使ってみてはどうか?とアドバイスいただいたため早速使ってみることにしました。

「プレスリリース」と「FAQ」を通じて企画を考える

今回は社内勉強会のため実際にプレスリリースを出すわけではないですが、参加者を募る際には勉強会についてのアナウンスを行いますのでそれをプレスリリースと見なすことにしました。

まずはじめにお客様を「全社員のうちファシリテーションを学びたい方々」とし、「望ましい顧客体験とは何か?」というところから考えてみました。

「望ましい顧客体験」を考えてみる

せっかく参加するなら1人で読書するだけでは得られないものが欲しいな、とか 今感じている問題を解決できたら嬉しいな、すぐに業務に役に立つ/業務が改善できるものだと嬉しいな、などと考えた結果以下2つを望ましい顧客体験と定義しました。

  • 座学だけではなく体験や実践ができること
  • 業務に直接役立つ学びがあること

「望ましい顧客体験」から逆算して詳細を考えてみる

次に定義した望ましい顧客体験を実現するために必要な要素を考えてみました。

座学だけではなく体験や実践ができること

  • 教師−生徒という関係だと座学みたいになりそうだから「学びたい人たちが集まって自分たちで学ぶ」ようにしよう
  • なるべく一人一人がたくさんの体験/実践を出来るように少人数のグループ制にしよう

業務に直接役立つ学びがあること

  • 何を目指す勉強会なのか明確にしよう
  • ファシリテーションが役に立つようなシチュエーションを詳細にイメージできるようにしよう
  • 具体的なツールの使い方についても学べる/体験できるようにしよう

「FAQ」を考えて詳細を詰める

次に「自分が勉強会に参加するのであれば何が気になるか?」という視点からFAQを考えて詳細を詰めることにしました。 ここではオーソドックスに5W1Hの視点を用いました。

Why: なぜ?

What:何を?

When: いつ?

  • Q: どれくらいの期間なのか?

    • A: 毎週1回/全8回を想定
  • Q: どのくらいの時間を使うのか?

    • A: 勉強会が毎回1時間とすると全8回で8時間、事前に教材を読む時間として2時間程度、合計10時間程度

Where: どこで?

  • Q: この勉強会はどこで開催されるのですか?
    • A: 弊社ではリモートワークを前提とした働き方を採用しているためこれに合わせフルリモートで開催

Who:だれが?

  • Q: 参加するためにどのような資格(役職/職位)が必要ですか?
    • A: ファシリテーションに興味があれば誰でもOK
      • 会議/MTGをより実り多いものにしたい方
      • チームメンバーにもっと積極的に会議/MTGに参加してほしいと感じているチームリーダー
      • 会議/MTGで発言しにくさを感じているチームメンバー

How:どのように?

  • Q: 具体的にどのような進め方をするのですか?イメージができないと不安/怖いです

    • A: 全8回を想定、人数としては5〜20人程度を想定しており、5人程度に分かれてグループワークする
  • Q: 事前に何か準備が必要ですか?

    • A: 事前に書籍を購入する
  • Q: 教材はどのように買えば良いですか?費用負担は誰がしますか?

    • A: 各自で購入 & 費用は会社負担(各自で経費精算する)
  • Q: 読書は業務時間内に行っても良いですか?

    • A: OK、ただし上長とは相談しておくこと

これらを盛り込んでプレスリリースを作成

次にここまでに考えた望ましい顧客体験やその詳細、FAQを元にプレスリリースの文面を作成しました。

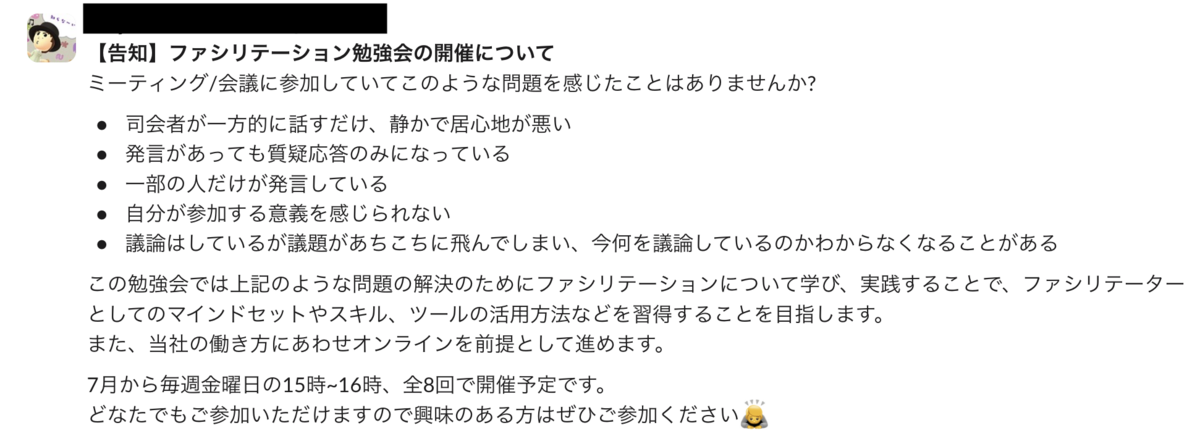
【告知】ファシリテーション勉強会の開催について

# 概要と目的

  ミーティング/会議に参加していてこのような問題を感じたことはありませんか?

    - 司会者が一方的に話すだけ、静かで居心地が悪い
    - 発言があっても質疑応答のみになっている
    - 一部の人だけが発言している
    - 自分が参加する意義を感じられない
    - 議論はしているが議題があちこちに飛んでしまい、今何を議論しているのかわからなくなることがある

  この勉強会では上記のような問題の解決を目指すために、ファシリテーションについて学び、実践し、
  ファシリテーターとしてのマインドセットやスキル、ツールの活用方法などを習得することを目指します。

# この勉強会で学べること

  - ファシリテーションのマインドセット
  - ファシリテーション・グラフィックをはじめとしたファシリテーションのスキル
  - Miroなどのオンラインホワイトボードの使い方

# 想定参加者

  どなたでもご参加いただけます。役職や職位、所属部門などの制限はありません。
  
  - 会議をより実り多いものにしたい方
  - チームメンバーにもっと積極的に会議/MTGに参加してほしいと感じているチームリーダー/マネージャー
  - 会議で発言しにくさを感じているチームメンバー
  
  人数は5~20人程度を想定しています。1グループ5人程度に分かれてワークを行う予定です。

# 参加方法

  - 次のURLからご参加ください。 https://example.com/xxx
  - 連絡用にSlackの #xxx にご参加ください。
  - 当日はZoomでご参加ください。
  - 不明点があれば@xxxまたは@yyyまでお問い合わせください。
  
# 教材と教材費について

  教材として以下を利用します。  
    - ファシリテーション・グラフィック[新版] 議論を「見える化」する技法 (堀公俊, 加藤彰)
  各自で購入して経費精算してください。
  経費精算時の予算コードはxxxをご利用ください。

# 勉強会の進め方

  毎週1回/全8回を予定しています。各回は1時間の予定です。
  
  - 第1回: オリエンテーション    
  - 第2回: 読書会 & 共有会  (1周目)
  - 第3回: 実践会(1周目) 
  - 第4回: ふりかえり会(1周目)    
  - 第5回: 読書会 & 共有会(2周目)
  - 第6回: 実践会(2周目) 
  - 第7回: ふりかえり会(2周目)    
  - 第8回: 全体のふりかえり会    
  
# その他注意点

  - この勉強会は講習(先生−生徒の関係)ではありません。各自が自分自身で学ぶことを重視します。
  - この勉強会は学んだことの共有/議論/実践の場です。
  - 読書は上長と相談の上で業務時間中に行なってください。

募集開始 〜 開催

作成したプレスリリースを用いて実際に参加者を募集をしてみました。

当初は10人くらい集まれば十分かなと思っていたのですが、予想に反し上限の20人を超える参加申し込みがありました。

想定参加者や目指す姿を書いておいたからか参加者の熱量は高く、とても充実した勉強会を開催できました。

ふりかえり

勉強会を開催しようとした当初は毎週集まって輪読会をする、くらいのぼんやりとしたイメージしか持てていなかったのですが、 プレスリリースやFAQを作成することを通じて半強制的に具体的なイメージを持てました。

例えばグループ分けについて当初は考え至っていなかったのですが、参加者目線で「座学だけではなく体験や実践ができること」を実現するために何が必要か考えたところ大人数ではファシリテーターをやる機会がなかなか回ってこないという問題に気付き少人数のグループ制にするというアイディアを思いつきました。

今回はあまり関係なかったですが、参加者目線から考えることで企画者がやりたいことと参加者の求めることのギャップにも気付けるというあたりはアジャイルなプロダクト開発ととても相性が良さそうに感じました。

おわりに

社内勉強会にWorking Backwardsという考え方を取り入れてみた体験談をお届けしました。
何かの参考になれば幸いです。

今回は以上です。お読みいただきありがとうございました。

参考文献

opentelemetry-go: exec.Commandで外部コマンドを呼ぶ時にトレースコンテキストを伝搬させる

exec.Commandで外部コマンドを起動する時にトレースコンテキストを伝搬させてみました

今回のコード例

github.com

環境変数+propagation.TraceContextを利用することで伝搬させてみました。

解説

httpやgRPCの場合のコンテキスト伝搬

こちらの記事にあるように、呼び出す側/呼び出される側の両方で以下のようにPropagatorを設定した上でotelhttpやotelgrpcなどのインターセプターを利用します。

otel.SetTextMapPropagator(
        propagation.NewCompositeTextMapPropagator(
                propagation.TraceContext{},
                propagation.Baggage{},
        ),
)

exec.Commandで外部コマンドを起動する時にはotelhttpやotelgrpcのようなインターセプターがありませんので自前でInject/Extractする必要があります。

どうやってトレースコンテキストを渡す?

W3C TraceContextのような仕様がないか探したのですが、いくつかの実装はあるものの仕様としてはまだない模様でした。

github.com

そこで参考としてequinix-labs/otel-cliでの環境変数経由でトレースコンテキストを参照する部分の実装をみたところ、

  • 環境変数名としてtraceparentを用いる
  • 値のフォーマットはW3C TraceContextを利用

となっていました。

これならpropagation.TraceContextの実装が使えるのでは?

上記の仕様で渡すのであればpropagation.TraceContextが使えそうです。
propagation.TraceContextは引数で渡されたpropagation.TextMapCarrierに対して読み書きを行います。

環境変数をなんらかの形でラップしてpropagation.TextMapCarrierの形にした上でInject/Extractを呼べばなんとかできそうです。

やってみた

改めて今回のコード例はこちらに置いています。

github.com

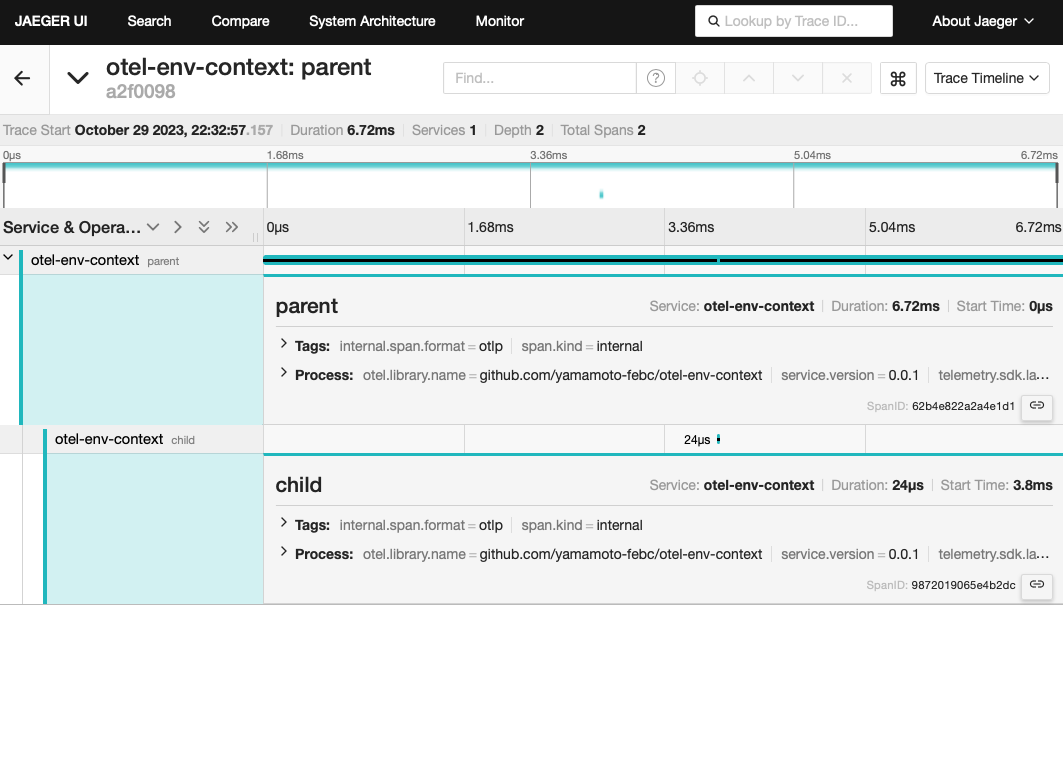
親コマンド側では以下のようにotel.GetTextMapPropagator().Inject()した上で環境変数を組み立てています。 https://github.com/yamamoto-febc/otel-env-context/blob/6db0d50cbf473c8c3095413657da234a57c63ddb/cmd/otel-parent/main.go#L47-L51

// 親コマンド側

// Propagatorに指定されているpropagation.TraceContextを用いてトレースコンテキストをenvCarrierに書き出し
envCarrier := propagation.MapCarrier{}
otel.GetTextMapPropagator().Inject(ctx, envCarrier)

// 書き出したトレースコンテキストを環境変数に設定
for _, key := range envCarrier.Keys() {
    cmd.Env = append(cmd.Env, key+"="+envCarrier.Get(key))
}

子コマンド側ではotel.GetTextMapPropagator().Extract()してあげます。 https://github.com/yamamoto-febc/otel-env-context/blob/4f30a8c453d64b567eecae2301226327114f1a5e/cmd/otel-child/main.go#L27-L33

// 子コマンド側

envCarrier := propagation.MapCarrier{
    "traceparent": os.Getenv("traceparent"),
    "tracestate":  os.Getenv("tracestate"),
}
// 環境変数からトレースコンテキストを抽出
parentCtx := otel.GetTextMapPropagator().Extract(context.Background(), envCarrier)

// トレース開始
ctx, span := otel.Tracer(instrumentationName).Start(parentCtx, "child")

これでいい感じにトレースコンテキストの伝搬ができてるはずです。

終わりに

もっといいやり方があれば是非教えてください。

以上です。

参考にしたサイト

christina04.hatenablog.com blog.cybozu.io www.w3.org github.com